Mostrando las entradas con la etiqueta dba jr. Mostrar todas las entradas

domingo, 7 de julio de 2013

Instalando Oracle 12cR1

En la primera parte vimos como poder instalar la maquina virtual y la instalación del sistema operativo Linux. Así que en esta parte vamos a ver la instalación de los binarios de Oracle y la creación de una Base de Datos vía el DBCA. De igual manera, vamos a ver que a diferencia de previos versiones de Oracle, aquí podemos crear  nuestra Base de datos de Contenedor de Tenencia múltiple (CDB) y  nuestra primera Base de Datos Conectables (PDB).

Instalación de Binarios de Oracle
Como se menciona en la primera parte de esta entrada, tenemos que verificar los prerequisitos de instalación, si no lo has hecho te recomiendo que lo verifiques en esta entrada. 
  • Como mencionamos en la parte de prerequisitos, configuramos la variable de ambiente, en donde tenemos la ruta donde se va a instalar los binarios (ORACLE_HOME).
    Una vez que tenemos inicializadas nuestras variables de ambiente, desde donde tenemos el Software de Oracle , corremos runInstaller para iniciar la instalación de los binarios.
  • Una vez que empieza el instalador, en mi caso deseleccione la configuracion con MOS (My Oracle Support), de la misma manera deje en blanco el correo electrónico.


  • En la siguiente parte, también le menciono que se brinque las actualizaciones de Software

  • En la siguiente sección vamos a decirle al instalador que queremos crear y configurar una Base de Datos.
  • En mi caso seleccionamos el tipo de Servidor, pero si vas a hacer pruebas o tienes recursos muy limitados, como en tu computadora , puedes seleccionar Desktop.
  • Para continuar seleccione un tipo de instalación de una sola instancia.

  • El tipo de instalación que seleccionamos es avanzada para poder configurar mas cosas.
  • Ahora seleccionamos el idioma en que vamos a correr, en mi caso seleccione ingles, este se los dejo a su conveniencia.
  • El tipo de instalación que lleve a cabo fue el de Enterprise Edition, esta es una selección que es de acuerdo a sus necesidades y licenciamiento que tienen.

  • En esta parte el instalador verifica lo que es el ORACLE_BASE y el ORACLE_HOME.


  • En esta parte el instalador vamos a seleccionar el Directorio donde se va a almacenar el Inventario de Oracle, así como el grupo primario para escribir en este directorio.


  • En mi caso seleccione el tipo de BD como de uso general

  • Este punto en la instalación, es lo que realmente hace la diferencia de versiones anteriores, aquí vamos a definir si la Base de datos de Contenedor de Tenencia múltiple (CDB) y el nombre de nuestra primera Base de Datos Conectables (PDB)

  • Aquí vamos a definir los parámetros de nuestra base de datos CDB ( Memoria, Tipo de set de caracteres)
  • Para continuar, vamos a seleccionar el destino donde vamos a guardar nuestros archivos de la base de datos, que en mi caso seleccione un directorio fijo, pero si tienes configurado ASM , aquí seria la parte donde lo harías.

  • Si tienes definido e instalado OEM 12c, aquí seria donde definirias la conexion para ella.
  • Ahora definiremos si queremos utilizar FRA, que es una característica de Oracle en donde se guardan los respaldos y todos los archivos que necesitas para recuperar tu base de Datos, y de igual manera, puedes usar ASM si lo tienes configurado, o un directorio fijo, que es lo que yo hice.

  • Vamos aquí a definir el password para los usuarios sys,system,dbsnmp y pdbadmin.
  • Ahora vamos a definir los grupos de sistema operativo, aquí es de igual manera, que fueron agregados nuevos grupos, como el de OSBACKUPDBA y OSDGDBA.

  • Ya casi acabamos, aquí lo que debemos de verificar es que se cumplan todos los requisitos, si no se cumplen, regresa y asegurate que todo este como debe de ser.

  • Una vez que arreglamos todos los prerequisitos necesarios, le damos siguiente y nos lleva a una pantalla de resumen de instalación, en donde podemos verificar si queremos hacer algún cambio a nuestra instalación, si estamos de acuerdo le damos siguiente e inicia la instalación.

  • Como penúltimo paso, tenemos que correr los scripts que te menciona el instalador, estos se corren con el usuario root.

  • Por ultimo paso, vemos que se crearon nuestra PDB y nuestra CDB, así como la dirección que tiene el Oracle Database Express 

Conclusión
Como podemos ver es sencilla la instalación de los binarios, en lo que tenemos que tener cuidado es en haber cumplido los prerequisitos de instalación, si es así el caso, vamos a tener una instalación sin complicaciones. Diviertete manejando la nueva versión de Oracle :)

martes, 14 de agosto de 2012

Un usuario tipo proxy y su gran uso para un DBA

El RDBMS de Oracle tiene dentro de sus métodos de autenticación una manera llamada usuario proxy, este usuario lo que te permite hacer es poder conectarte con las credenciales que tu tienes (usuario y contraseña que tu ya conoces) y ejercer acciones en un usuario en el que tu no tienes contraseña.

Y te vas a preguntar, pues para que me sirve esto si ya soy un super usuario, bueno una de las primeras cosas que se me viene a la mente es crear un database link privado, ya que la unica manera de crearlo es si estas conectado como el usuario que requiere el database link :)

Aquí te voy a dar un ejemplo de como crear un usuario proxy y como usarlo, ya tu te divertirás con las cosas que puedes hacer con este método de autenticación.

Lo primero que voy a hacer es crear un llamado usuario_princi y un usuario llamado usuario_proxy, después de crear el usuario proxy, vas a ver que altero al usuario para darle un grant connect through, esto es lo que nos va a permitir conectarnos como un usuario proxy

TESTDB> create user usuario_princi identified by 1234;

User created.

TESTDB> create user usuario_proxy identified by proxy1234;

User created.

TESTDB> grant create session, create table to usuario_princi;

Grant succeeded.

TESTDB> alter user usuario_princi grant connect through usuario_proxy;

User altered.

Una vez que creamos al usuario proxy, nos conectamos de la siguiente manera, vas a ver que aunque estoy usando el usuario y contraseña de usuario_proxy, mi esquema de contexto es usuario_princi

TESTDB> connect usuario_proxy[usuario_princi]/proxy1234
Connected.
USER: USUARIO_PRINCI
SESSION ID: 45
CURRENT_SCHEMA: USUARIO_PRINCI
INSTANCE NAME: TESTDB
DATABASE ROLE: PRIMARY
OS USER: oracle
CLIENT IP ADDRESS:
SERVER HOSTNAME: servidor1
CLIENT HOSTNAME: servidor1.oracleenespanol.blogspot.com

PL/SQL procedure successfully completed.

TESTDB> select sys_context('userenv','current_user') from dual;

SYS_CONTEXT('USERENV','CURRENT_USER')
--------------------------------------------------------------------------------
USUARIO_PRINCI

TESTDB> select sys_context('userenv','proxy_user') from dual;

SYS_CONTEXT('USERENV','PROXY_USER')
--------------------------------------------------------------------------------
USUARIO_PROXY

Ahora como ejemplo, vamos a crear una tabla y vas a ver que esta tabla se crea en el usuario_princi, no en el usuario_proxy que fue con el que nos conectamos

TESTDB> create table prueba (id number);

Table created.


TESTDB> select owner from all_tables where table_name='PRUEBA';

OWNER
---------------
USUARIO_PRINCI

Ya nada mas para verificar , audite a la sesión y las acciones de crear una tabla para los usuarios y el resultado es este

TESTDB> AUDIT CREATE TABLE BY usuario_proxy ON BEHALF OF usuario_princi;

Audit succeeded.

TESTDB> AUDIT CREATE TABLE BY usuario_princi BY ACCESS;

Audit succeeded.

TESTDB> SELECT
  2  tr2.username PROXY,
  3  tr1.username USERNAME,
  4  tr1.extended_timestamp,
  5  tr1.owner,
  6  tr1.obj_name,
  7  tr1.action_name,
  8  tr1.returncode ,
  9  tr1.SESSIONID,
 10  tr1.PROXY_SESSIONID
 11  FROM dba_audit_trail tr1,
 12  dba_audit_trail tr2
 13  WHERE tr1.obj_name not in ( 'DUAL','SQLPLUS_PRODUCT_PROFILE','PRODUCT_PRIVS')
 14  AND tr1.proxy_sessionid=tr2.sessionid
 15  AND tr2.action_name='PROXY AUTHENTICATION ONLY' and tr2.username='USUARIO_PROXY' and tr1.owner='USUARIO_PRINCI'
 16  ORDER BY tr1.timestamp;

PROXY           USERNAME        EXTENDED_TIMESTAMP        OWNER           OBJ_NAME   ACTION_NAME     RETURNCODE  SESSIONID PROXY_SESSIONID
--------------- --------------- ------------------------- --------------- ---------- --------------- ---------- ---------- ---------------
USUARIO_PROXY   USUARIO_PRINCI  14-AUG-12 04.31.30.650906 USUARIO_PRINCI  PRUEBA     CREATE TABLE             0   14900441        14900440
                                 AM -07:00

Como te puedes dar cuenta este método te puede ayudar para crear un database link en el usuario o de igual manera le puede ayudar a tu desarrollador para que se conecte a un usuario y no tener que crear sinónimos.

sábado, 30 de junio de 2012

Un buen truco para poder mandar un comando en sqlplus via nohup y poder irte a dormir

Uno de las grandes desventajas que tenemos como DBAs es que mucho de nuestro trabajo son a deshoras, y de igual manera requieren de scripts que toman a veces dos o tres horas en correr, asi que si son las dos de la mañana, tres horas de poder dormir a nadie le caen nada mal, especialmente si lo unico que tienes que es estar monitoreando y asegurandote que un script corra bien.

Asi que una manera para que te puedas ir a dormir y nada mas despertarte es si llega a fallar el script

Lo primero que ahi que hacer, y esto es importante que en el ambiente que lo hagas, tengas el permiso para poder hacerlo, es poner el password en un archivo de texto y con permisos 400

oracle@servidor1.oracleenespanol.blogspot.com [TESTDB1] /mount/dba01/oracle/TESTDB/scripts
oracle $ ls -ltr passfile.txt
-r-------- 1 oracle oinstall 13 Jun  30 20:58 passfile.txt


oracle@servidor1.oracleenespanol.blogspot.com [TESTDB1] /mount/dba01/oracle/TESTDB/scripts
oracle $ cat passfile.txt
hr:12345

En un script de shell de unix vas a poner lo que esta abajo

. ${HOME}/bin/TESTDB
HR_PASS=`cat  /mount/dba01/oracle/DBATEST/admin/passfile.txt | grep hr | cut -d: -f2`
LOG_DIR=${SID_HOME}/audit
sqlplus /nolog <<EOF > ${LOG_DIR}/test.log
connect hr/${HR_PASS}
select sysdate from dual;
exit
EOF

oracle_error=`cat ${LOG_DIR}/test.log | grep "ORA-" | wc -l`
if [ ${oracle_error} -gt 0 ]; then
     echo "###############################################################"
     echo "## ERROR ====> Unable to get the Date"
     cat ${LOG_DIR}/test.log | grep ORA- | awk '{print "##", $0}'
     echo "###############################################################"
     mailx -s "Error in Getting the Time" rene.antunez@blogspot.com < ${LOG_DIR}/test.log
     exit 1
fi

Ya una vez que tengas tu shell script, ya nada mas lo tienes que mandar en modo nohup y te puedes ir a dormir o comer en lo que corre tu script, si llega a fallar, te llegaria un correo con el error y donde es que fallo. De igual manera, puedes cambiar el select por un script de sql.


oracle@servidor1.oracleenespanol.blogspot.com [TESTDB1] /mount/dba01/oracle/TESTDB/scripts
oracle $ nohup ./test.sh &

jueves, 8 de marzo de 2012

Como medir el desempeño de un DBA


Antes de que continúes leyendo, quiero informarte que no encontraras la respuesta aquí, si no que esto es una reflexión de lo complicado que es medir el desempeño estándar de un DBA,

Y es aquí donde entra lo complejo, por que vamos a ver si lo medimos por la cantidad de requerimientos que recibe y termina, me ha tocado ver situaciones en donde en un equipo de 10 DBAs, el que mas numero de requerimientos terminaba era un DBA Jr que sus tareas mas complejas era hacer un export/import.

Si lo medimos los requerimientos por la manera de "Cero defectos en la primera entrega", nos enfrentamos a que tenemos normalmente un ambiente y flujo de trabajo que pasa por desarrollo luego pruebas y finalmente por producción.

En que parte del proceso de los requerimientos mides los cero defectos , en producción o los empiezas a medir desde que recibes tu requerimiento en desarrollo, cuando lo que van a salir son todos los errores que pasas a pruebas para tratar de eliminarlos?

Y que pasa cuando nada falla en desarrollo y pruebas, pero llegas a producción y eres el gran afortunado de descubrir un nuevo bug en la versión que estas trabajando?

Me dirás, la manera que lo puedo medir es en el numero de queries exitosos que hacemos a la base de datos y estos responden en el tiempo adecuado? Para empezar de que manera se define exitoso, que no falla o que sencillamente regresa los datos que debería? Y en tiempo, como puedes definir el tiempo adecuado si un query depende no tanto de ti, si no de los desarrolladores y de la cantidad de datos que regresa, de la misma forma, si un query me regresa datos en 30 minutos o 1 segundos, todo depende del proceso que estés corriendo, los dos pueden estar bien o pueden estar mal.

Existen varias cosas que si creo que puedes medir, pero no de una forma de rendimiento estándar, si no de la salud del ambiente y tus bases de datos

  • • El tiempo que la base de datos esta disponible en acuerdo con los SLAs establecidos.
  • • El numero de alarmas del mismo tipo que recibiste el mes pasado contra las de este mes, y que se hizo para reducirlo.
  • • La cantidad de Base de Datos que tienen los estándares establecidos en los SLAs por la empresa y por tu equipo.
  • • El numero de pruebas de desastre que son exitosas en el año.
  • • La cantidad de respaldos exitosos/no exitosos que tuviste en el mes.

Como puedes ver es complejo por que desde mi punto de vista un DBA se debe de medir de forma cualitativa no cuantitativa. Y para medirlo de forma cualitativa la formula es por cada DBA y por cada ambiente que tienes.

Al ultimo la realidad del desempeño de un DBA, es que se acaba midiendo por que tan bien ejerce sus funciones en la adversidad de una situación; Es ese 10% de las situaciones catastróficas que no fueron causadas por el mismo y que tiene un DBA en su profesión que acaba determinando si es un buen DBA o no.

martes, 6 de marzo de 2012

Eres tan bueno como tus ultimos 5 minutos

La semana pasada mientras yo estaba tan tranquilo modificando unos scripts para un respaldo, un amigo me contacta via messenger que un DBA jr acaba de correr un script en producción cuando lo tenia que ejecutar en desarrollo!

Lo primero que se me vino a la mente fue preguntar: Que fue lo que corrió?

Esto para ver si tenia una solución sencilla, y su respuesta fue algo que me hizo sentir alivio, "Si , fue nada mas crear unos esquemas." En ese momento respire tantito alivio, mas sin embargo escribió la siguiente palabra "pero...". Esa palabra hizo la diferencia.

Lo que sucedió fue al tratar de arreglar la situación, tiro esquemas que no debería de haber tirado.

Y en ese momento fui recordado de este gran dicho en el mundo de DBAs, "Eres tan bueno como tus últimos 5 minutos" , creo que es una de las mejores frases que describe lo fragil que es nuestra profesión, ya que como lo he predicado , nuestro trabajo mas alla de ser constructivo es un trabajo destructivo. Si tu logras ver que tu trabajo como DBA es de esta forma, vas a tener mas cuidado en todo lo que haces.

Ya he escrito una entrada de como identificar en donde estamos trabajando , y aqui te paso un script que usa Uwe Hesse

set serveroutput on
begin
dbms_output.put_line('USER: '||sys_context('userenv','session_user'));
dbms_output.put_line('SESSION ID: '||sys_context('userenv','sid'));
dbms_output.put_line('CURRENT_SCHEMA: '||sys_context('userenv','current_schema'));
dbms_output.put_line('INSTANCE NAME: '||sys_context('userenv','instance_name'));
dbms_output.put_line('DATABASE ROLE: '||sys_context('userenv','database_role'));
dbms_output.put_line('OS USER: '||sys_context('userenv','os_user'));
dbms_output.put_line('CLIENT IP ADDRESS: '||sys_context('userenv','ip_address'));
dbms_output.put_line('SERVER HOSTNAME: '||sys_context('userenv','server_host'));
dbms_output.put_line('CLIENT HOSTNAME: '||sys_context('userenv','host'));
end;
/

Y el resultado del script se ve asi:

USER: SYS
SESSION ID: 23
CURRENT_SCHEMA: SYS
INSTANCE NAME: TESTDB
DATABASE ROLE: PRIMARY
OS USER: oracle
CLIENT IP ADDRESS:
SERVER HOSTNAME: servidor1
CLIENT HOSTNAME: servidor1.oracleenespanol.blogspot.com

Así que la próxima ves que vayas a hacer algún trabajo, enfocate en tu tarea, trata de no estar haciendo varias cosas a la vez, identifica y lee las especificaciones de la tarea a hacer e identifica donde la tienes que hacer, esto te ayudara a minimizar los errores en el futuro, suerte !

domingo, 10 de abril de 2011

Un commit hace que mi informacion se escriba en los datafiles?

El otro día recibí la pregunta que si en el momento que hago commit, los datos los encuentro en los datafiles?

Para poder entender esta pregunta, primero debemos conocer un poco los procesos y las estructuras de memoria que tiene Oracle, te invito a que vayas a la entrada Instancia es igual a procesos y memoria para que tengas una mejor idea de varios de los procesos que vamos a hablar aqui.

Lo primero que hay que entender es que el DBWn es un proceso flojo,ya que no es un proceso que cada n segundos este escribiendo los datos del Buffer Cache a los datafiles, si no que es activado por otro proceso (Como CKPT por ejemplo).

Tomemos el siguiente ejemplo,supon que yo siendo el todopoderoso, incremento mi salario de 1 USD a 5 USD en la tabla employees, e inmediatamente despues hago un commit.

Pregunta, si yo ya hice un commit, encontraría el valor de 5 USD en los datafiles?

Antes de responder esta pregunta, vamos a poner otra situación con el mismo ejemplo, en lugar de cometer mis datos después del incremento salarial que me di,decido esperarme el fin de semana para reflexionar en este cambio, solamente dejo la sesión abierta sin cometer los datos.
El lunes que regreso, y verifico los datos directamente en los datafiles, que valor encontraría, 1 o 5 USD?

La lógica me llevaría a decir que, 1 USD, ya que nunca cometí mis datos, cierto?

Una ultima pregunta con este escenario,acuerdate que no hemos cometido los datos,si yo checara los datos en el Online Redo Log, que valor encontraria, 1 o 5 USD?

Si tu respuesta fue 1 USD, seria la mas lógica, ya que no he cometido los datos y no son necesarios para el proceso de recuperación en caso de que mi base de datos se cayera, si respondiste 5 USD, entonces como explicarías el proceso de recuperación en caso de que se haya caído la instancia, si cuando se hace una recuperación los procesos leen del Online Redo Log, y el valor que se encuentra es el de 5 USD?

Antes de empezar, y para que no se te quemen las habas,las respuestas son 1,5 y 5 USD

Vamos a tratar de explicarlo aquí abajo

Crea un tablespace pequeño, en este casa de 1M, y crea en el usuario hr, una tabla llamada prueba_salario, y en esta tabla inserta el dato de salario


TESTDB >create tablespace prueba datafile '/mount/u01/oracle/TESTDB/data/pruebas01.dbf' size 1m;

Tablespace created.

TESTDB >create table hr.prueba_salario (salario varchar2(200)) tablespace prueba;

Table created.

TESTDB >insert into hr.prueba_salario values ('1_USD');

1 row created.

TESTDB >commit;

Commit complete.

Una vez que completes esto, recicla la base de datos, ya que no queremos que nada se encuentre en memoria, y si te fijas, el dato de 1_USD lo puedes ver
en el datafile

oracle@localhost [TESTDB] /mount/u01/oracle/TESTDB/data
root $ strings /mount/u01/oracle/TESTDB/data/pruebas01.dbf

z{|}
5wXTESTDB
PRUEBA
1_USD

Y ahora haz un update a la tabla hr.prueba_salario y realiza un commit, inmediatamente después verifica de nuevo el datafile, y te vas a dar cuenta
que este dato que acabas de actualizar no se encuentra en el datafile, que sigues viendo el valor de 1_USD

TESTDB >update hr.prueba_salario set salario = '5_USD';

1 row updated.

TESTDB >commit;

Commit complete.

oracle@localhost [TESTDB] /mount/u01/oracle/TESTDB/data
root $ strings /mount/u01/oracle/TESTDB/data/pruebas01.dbf

z{|}
5wXTESTDB
PRUEBA
1_USD

En el momento que mandamos llamar al proceso de CKPT, es cuando los buffers "sucios" se escriben a disco, despues de que hagas un checkpoint,
verifica de nuevo el datafile, y te vas a dar cuenta que el datafile esta actualizado con el nuevo valor de 5_USD.


TESTDB >alter system checkpoint;

System altered.

oracle@localhost [TESTDB] /mount/u01/oracle/TESTDB/data
root $ strings /mount/u01/oracle/TESTDB/data/pruebas01.dbf

z{|}
5wXTESTDB
PRUEBA
5_USD

Ahora vamos a hacer otra prueba, tira la tabla prueba_salario, vuelvela a crear, vuelve a insertar el dato de 1_USD y una vez que finalices esto, recicla la base de datos para asegurarnos que no se encuentre nada en memoria.

Ahora vamos a hacer un update a la tabla de prueba salario, y no vamos a hacer un commit, solamente vamos a llamar al proceso de CKPT.

TESTDB >update hr.prueba_salario set salario = '5_USD';

1 row updated.

TESTDB >alter system checkpoint;

System altered.

Si te fijas abajo, el dato de 5_USD es el que se encuentra en el datafile y no el de 1_USD, aunque no hemos hecho un commit de los datos.


oracle@localhost [TESTDB] /mount/u01/oracle/TESTDB/data
root $ strings /mount/u01/oracle/TESTDB/data/pruebas01.dbf

z{|}
5wXTESTDB
PRUEBA
5_USD

Abre una nueva sesión y haz un query a la tabla y te fijaras que el dato de 1_USD es el que te arroja, que es el correcto ya que no hemos cometido los datos


TESTDB >select * from hr.prueba_salario;

SALARIO

------------------------

1_USD

Una de las preguntas que te has de estar haciendo en este momento, es como Oracle sabe que información arrojar, si en el datafile se encuentra el valor de 5_USD. Oracle logra esto a través de un flujo que se llama Consistencia de Lectura (Read Consistency [RC]).

Antes de continuar hay que conocer que es el SCN (System Change Number), este es el punto logico
en el tiempo en el que los cambios se hacen a la base de datos.

El flujo de RC funciona con el SCN para garantizar el orden de las transacciones, cuando lanzaste el query en la sesión nueva, la base de datos determina el SCN registrado en el momento que el query se empezó a ejecutar.

Este select requiere una versión de los bloques de datos que sean consistentes con los cambios que únicamente se encuentran cometidos. Oracle copia los bloques que se encuentran en los bloques actuales a un buffer de datos nuevo y le aplica datos de undo para reconstruir las versiones anteriores de los bloques de datos. A estas copias se le conocen como clones de consistencia de lectura(Consistency Read Clones).

Para saber si la transaccion esta cometida o no, Oracle utiliza una tabla de transacciones llamada lista de transacciones de interes (Interested Transaction List [ITL]), esta lista se encuentra en la cabecera del bloque.

Para terminar y regresar al punto, si sabemos que el DBWn es un proceso flojo, y que aunque haga un commit de mis datos, estos pueden que no se encuentren en los datafiles.

¿De donde toma Oracle la información para esto si se me llegara a caer la base de datos antes de que el CKPT mandara a llamar al DBWn?

La respuesta esta en el Online Redo Log y cuando encuentra el marcador de commit, como ya habíamos platicado de lo que es el Online Redo Log, no voy a entrar mas a detalle en este tema, pero como puedes ver por los ejemplos anteriores, el Online Redo Log, es critico para la consistencia de nuestros
datos.

Conclusion

Espero que con esta explicación puedas comprender la importancia de los Online Redo Logs, ya que si los llegaras a perder, puedes tener perdida de información en tu base de datos, también vimos un poco de como funciona el undo y como se logra la consistencia de lectura a través de sesiones sin cometer.

P.D. Quiero Agradecer a Arup Nanda por permitirme utilizar gran parte de su material para esta entrada, 100 Things You Probably Didn't Know.

Actualización

04/Dec/2012: No me habia fijado que el formato de SQL de esta entrada se habia perdido, asi que se lo volvi a poner.

jueves, 31 de marzo de 2011

Instancia es igual a Procesos y Estructuras de memoria

La definicion de una instancia es sencilla y basica, es un conjunto de estructuras de memoria que manejan los archivos de la base de datos, cuando inicia la instancia, con ella inician procesos de fondo (Background Process), como el LGWR, PMON, etc.

Importante saber que al menos una base de datos activa o mejor dicho que esta corriendo, debe de tener una instancia asociada. De la misma manera, como la instancia existe en memoria y la base de datos existe en disco, una instancia puede existir sin una base de datos y una base de datos puede existir sin una instancia, si no me crees esto, haz la prueba, arranca la instancia en modo nomount y veras que sin existir los datafiles,controlfiles y redo logs puedes iniciar la instancia


TESTDB >startup nomount

ORACLE instance started.
Total System Global Area 1369989120 bytes
Fixed Size 2158184 bytes
Variable Size 268439960 bytes
Database Buffers 1090519040 bytes
Redo Buffers 8871936 bytes

oracle@localhost [TESTDB] /mount/dba01/oracle/TESTDB/admin
oracle $ ps -eaf | grep TESTDB

oracle 27411 1 0 01:21:35 ? 0:00 ora_pmon_TESTDB

oracle 27448 1 0 01:21:37 ? 0:00 ora_ckpt_TESTDB

oracle 27435 1 0 01:21:37 ? 0:00 ora_dia0_TESTDB

oracle 27439 1 0 01:21:37 ? 0:00 ora_dbw0_TESTDB

oracle 27454 1 0 01:21:37 ? 0:00 ora_mmon_TESTDB

oracle 27415 1 0 01:21:35 ? 0:00 ora_psp0_TESTDB

oracle 27444 1 0 01:21:37 ? 0:00 ora_dbw1_TESTDB

oracle 27431 1 0 01:21:37 ? 0:00 ora_diag_TESTDB

oracle 27446 1 0 01:21:37 ? 0:00 ora_lgwr_TESTDB

oracle 27452 1 0 01:21:37 ? 0:00 ora_reco_TESTDB

oracle 27450 1 0 01:21:37 ? 0:00 ora_smon_TESTDB

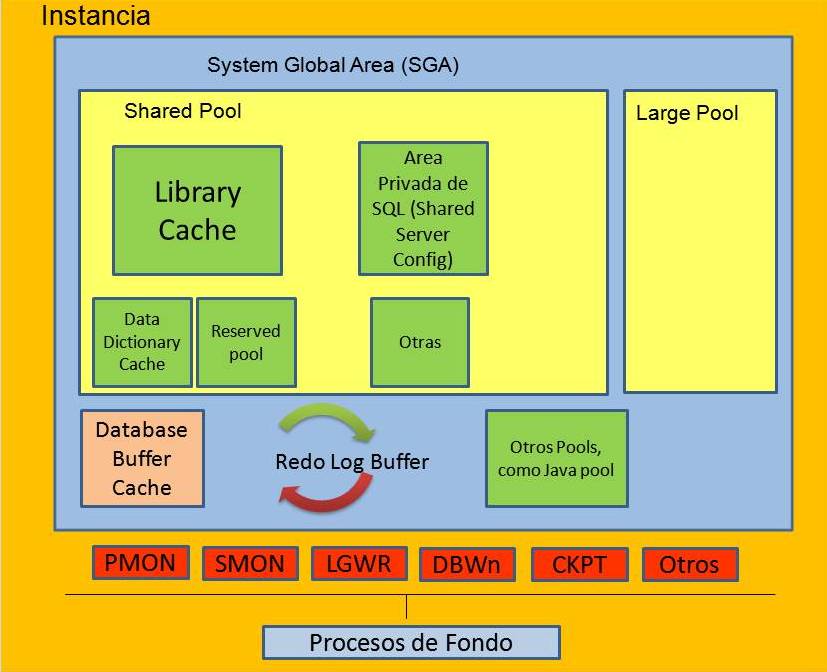
Aqui abajo esta una pequeña grafica de como se conforma una instancia:


Y debido a lo que platicamos arriba, es lo que permite la configuracion para RAC (Real Application Cluster), asi tambien es importante saber que una instancia no puede tener asociada una sola base de datos a la vez, o sea que no puedes montar dos base de datos en una instancia.

Memoria
La memoria SGA tiene 3 estructuras básicas:

Database buffer cache.- Es el área de memoria que almacena copias de los bloques de datos leídos de los data files.Tambien a esta área se le conoce nada mas como Buffer Cache. Esta seccion de la memoria tiene tres estados.
  • Sin Usar (Unused).-El buffer esta disponible por que nunca se ha usado o actualmente esta sin usar.
  • Limpia (Clean).-Este buffer fue usado previamente, y ahora contiene una version consistente del bloque de datos en un punto en tiempo. El bloque contiene datos, pero este se puede decir que esta limpio, ya que no se le necesita hacer un checkpoint a los datos.
  • Sucia (Dirty).-El buffer contiene datos que no han sido escrito a disco, Oracle necesita hacer un checkpoint del bloque de datos antes de reusarlo.
  • Para manejar estos estados, Oracle tiene un algortimo llamado LRU (Least Recently Used), lo que hace este algoritmo es sacar del buffer a los bloques de datos menos usados y que ya se le hayan hecho un checkpoint para asi poder subir al Buffer Cache nuevos datos y evitar sacar del Buffer Cache los datos que se usan con frecuencia.

Shared Pool .- Esta área de memoria guarda SQL analizado (Parsed),parámetros del sistema y el diccionario de datos (Data Dictionary Cache y Library Cache).

Redo Log Buffer.- Esta estructura de memoria en el SGA, que guarda los registros de Redo, estos contienen la información necesaria para reconstruir los cambios hechos por DDLs o DMLs a la base de datos.

Procesos
Existen varios que son obligatorios, como los mencionados aqui abajo, de la misma manera existen muchos procesos que se inician una vez que añades alguna funcionalidad, como el ARCn, que es cuando la base de datos esta en modo archivelog.

PMON.- La funcionalidad de este proceso es la de monitorear que los demás procesos de la instancia estén corriendo, a su vez es responsable de limpiar el Database Buffer Cache y limpiar recursos que el cliente haya utilizado.

SMON.-La tarea principal de este proceso es la de limpieza a nivel sistema, y también una de las tareas principales de este proceso es llevar a cabo la recuperación al iniciar la instancia cuando anteriormente finzalizo de una manera abrupta, como un shutdown abort o un crash del servidor.

CKPT.-Su función es la de actualizar las cabeceras de los control files y de los data files, con información de Checkpoint (SCN, Posición de Checkpoint, etc), a su vez la avisa al DBWn que debe de escribir los bloques del Buffer Cache a disco. Muy importante saber, que el CKPT no escribe los datos, ni al Redo Log ni a los data files.

DBWn.-Este proceso escribe los contenidos sucios del buffer Cache, a este proceso se le conoce como un proceso flojo, ya que por si solo no escribe a disco, este unicamente escribe a disco cuando no hay bloques de datos limpios en el buffer cache o cuando CKPT le informa que debe hacerlo.

LGWR.- De lo que se encarga es de escribir los Redo Log Buffers a disco (Online Redo Log). Este proceso utiliza un método que se le conoce como Fast Commit. Cuando un usuario ejecuta un commit, a la transacción se le asigna un SCN (System Change Number), LGWR pone una marca de commit en el Buffer Cache e inmediatamente escribe a disco, cuando se han escrito estos datos en el Online Redo Log, el proceso actualiza el Buffer Cache haciendo mención de que estos ya se escribieron a disco.

Conclusion
Espero que esta pequeña explicación te ayude a comprender la diferencia entre la Instancia y lo que en Oracle se conoce como Base de Datos. De la misma manera los procesos basicos y memoria basica de la instancia, para los procesos y la memoria existen mas de los mencionados aqui, pero estos son los minimos necesarios en una configuracion de Oracle.

miércoles, 30 de marzo de 2011

Que es un Online Redo Log

Que es Online Redo Log?
El Online Redo log, es una estructura fisica que consiste de minimo de dos archivos, estos a su vez pueden estar multiplexados en dos o mas copias identicas, que a estos se le conocen como miembros de un grupo de Redo log. Como mencionamos, el Online Redo Log consiste de minimo dos archivos, esto permite que Oracle escriba en un archivo de Online Redo Log mientras el otro se archiva (Cuando mencionamos archivar, es si la base de datos se encuentra en modo ARCHIVELOG).
En los Online Redo logs se almacenan registros de Redo, los cuales estan conformados por vectores de cambio (change vectors), cada uno de estos vectores describe los cambios a un bloque de datos.

Todos los registros de tipo redo tiene metadata relevante al cambio, incluyendo:
  • SCN y la estampa de tiempo del cambio
  • El ID de la transaccion que ha generado el cambio
  • SCN y la estampa de tiempo cuando la transaccion fue cometida (si es que fue cometida)
  • Tipo de operacion que efectuo el cambio
  • Nombre y tipo del segmento de dato modificado

Los Online Redo Log son usados unicamente en el proceso de la recuperación de la base de datos.
Basicamente,lo que hay que entender como principio, es que cuando algun DML (insert,update o delete) o un DDL (alter, create, drop) sucede en nuestra base de datos, Oracle registra los cambios en memoria, en un buffer llamado Redo Log Buffer, que con este buffer hay un proceso asociado llamado LGWR.

El proceso LGWR de lo que se encarga es de escribir de la estructura de memoria (Redo) Log Buffer a los Online Redo Logs, y muy importante es saber cuales son las circunstancias que hacen que el LGWR escriba al Online Redo Log:
  • Cuando un usuario hace un commit a la transaccion
  • Cuando sucede un cambio (log switch) de archivo de Redo Log
  • Cuando han pasado tres segundos desde la ultima escritura del LGWR hacia el Online Redo Log
  • Cuando el Redo Log Buffer esta 1/3 lleno o contiene mas de 1Mb de datos en el buffer.
  • Cuando el proceso DBWn necesita escribir datos del Database Buffer Cache hacia disco.
El proceso LGWR escribe a los archivos de Online Redo Log de manera circular, cuando el LGWR escribe en el ultimo archivo de Online Redo Log disponible, el LGWR se regresa a escribir al primer archivo de Online Redo Log.

Ahora que ya vimos que es , y como mencionabamos arriba, los Online Redo Logs, son unicamentes usados en el proceso de recuperacion de la base de datos.

En el proceso de recuperacion, se presenta tanto lo que es aplicar cambios cometidos no reflejados en los datafiles, a esto se le conoce como Roll Forward, y remover los cambios aplicados no cometidos de los datafiles, a esto se le conoce como Roll Back.

Suena un poco confuso, pero realmente no lo es, lo unico que hay que saber es que cuando se realiza un commit, Oracle añade un Marcador de Commit en el redo log buffer, asi es como Oracle sabe que datos son cometidos y cuales no.

Aqui un pequeño algoritmo de como es el proceso de recovery, este lo tome del blog de Arup Nanda, no me lo acredito, solamente lo estoy traduciendo:

Leer las entradas de tipo Redo Log, empezando con el mas antiguo
Verificar el numero SCN del Cambio
Buscar el Marcador de Commit.
Si el marcador es encontrado, entonces los datos han sido cometidos.
Si es encontrado, entonces buscar los cambios en los datafiles (via el numero SCN)
    ¿Cambios estan reflejados en los datafiles?
    Si si, entonces brinca
    Si no,aplicar los cambios a los datafiles (Roll Forward)
Si no es encontrado,entonces los datos estan sin cometer,buscar los cambios en los datafiles
    ¿Cambios estan reflejados en los datafiles?
    Si no, entonces brinca
    Si si, entonces hacer un update a los datafiles con los datos antes del cambio (Roll Back)

Para ver la informacion que tiene los redo logs, puedes hacer una sesion de logminer, que eso lo veremos en otra entrada, pero por el momento te esneño un ejemplo de la informacion que puedes ver.

En una sesion con el el usuario HR, voy a crear una tabla llamada BLAH, y voy ver la informacion de la transaccion, una vez que veo esta informacion voy a darle commit para finalizar la transaccion.

TESTDB >create table blah( name varchar2(100), num number);

Table created.

TESTDB >insert into "HR"."BLAH"("NAME","NUM") values ('Texto Nada Mas Probar Que Inserto','60671');

1 row created.

TESTDB >select dbms_transaction.local_transaction_id from dual;

LOCAL_TRANSACTION_ID
--------------------------------------------------------------------------------
47.30.24303

TESTDB >commit;

Commit complete.

Ahora uso la utileria de log miner para poder ver esta informacion del redo log utilizando el XID de la transaccion de arriba, y aqui podemos ver la informacion del SQL_REDO y SQL_UNDO

column sql_redo format a30 word_wrapped
column sql_undo format a30 word_wrapped
column seg_owner format a12
select seg_owner,SQL_REDO,SQL_UNDO FROM V$LOGMNR_CONTENTS where XIDUSN=47 and XIDSLT=30 and XIDSQN=24303

SEG_OWNER SQL_REDO SQL_UNDO
------------ ------------------------------ ------------------------------
set transaction read write;
HR insert into delete from "HR"."BLAH" where
"HR"."BLAH"("NAME","NUM") "NAME" = 'Texto Nada Mas
values ('Texto Nada Mas Probar Que Inserto' and "NUM"
Probar Que Inserto','60671'); = '60671' and ROWID =
'AAATuqAAEAAAA+YAAA';

commit;

Conclusion
Espero que con esta pequeña informacion de lo que es un Redo Log y con la entrada anterior de lo que es un registro tipo undo puedas ver la diferencia entre ambos y su uso especifico de estos.

miércoles, 19 de enero de 2011

Que es un registro tipo Undo

Aqui de nuevo en Oracle en Español, tratando de demistificar a la base de datos para poder entenderla, esta entrada esta un poco larga, ya que voy a tratar de dar una pequeña explicacion de lo que son los registros e información tipo Undo y todo lo que lo rodea.

Primero que nada, debemos conocer lo que es una transaccion.

Que es una Transaccion?
Una transacción es una unidad lógica y atómica de trabajo que contiene una o más sentencias de SQL. Una transaccion agrupa operaciones SQL, de forma que, o a todas las operaciones se le hace un commit, lo que significa que se aplican a la base de datos, o a todas se hace un rollback, lo que significa que se deshacen de la base de datos. Una transaccion debe de tener las propiedades de ACID

Que es un registro Undo?
Basicamente es informacion que es utilizada por Oracle para hacer un rollback (deshacer), a los cambios que hemos hecho a nuestros datos en una transaccion y principalmente tiene los siguientes tres usos:
  • Deshacer los datos en nuestra transaccion cuando ejecutamos el comando ROLLBACK
    Cuando ejecutamos un rollback,los registros de Undo son usados para deshacer los cambios en la Base de Datos a nuestra transaccion que no ha efectuado un commit.
  • Poder tener consistencia de lectura de datos
    Oracle utiliza los registros de tipo Undo para mantener una imagen consistente de los datos, mientras son modificados por otro usuario.
  • Recuperar la Base de Datos
    Los registros de tipo Undo son usados en la recuperacion de la Base de Datos, para deshacer cualquier cambio en nuestros datos a los que no se haya efectuado commit y se encuentre en los datafiles.
Este registro es manejado en un tablespace especial de tipo undo, y puedes ver que tablespace es de tipo undo en la vista dba_tablespaces
TESTDB >select tablespace_name 
from
 dba_tablespaces where contents='UNDO';
TABLESPACE_NAME
------------------------------
UNDOTBS


En este tablespace se van a almacenar unicamente segmentos de tipo undo, que a su vez este segmento esta compuesto de minimo dos undo extents,los segmentos de tipo undo son escritos en ellos de forma circular.

En este tipo de tablespace no podemos almacenar una tabla o un indice, el mismo manejador de base de datos no lo permite. Tambien hay que saber que la base de datos nos permite tener mas de un tablespace de tipo undo pero solamente uno puede estar activo a la vez.

Existe dos tipos de manejo de los registros de undo, ya sea de tipo Manual o Automatico, que el default en 11g es Automatico.En el modo Automatico, los registros de undo son manejados en lo que se conoce como segmentos de undo, en el modo manual, los registros de undo se manejan en segmentos de rollback y no se utiliza el tablespace de tipo undo.

La informacion de tipo undo se divide en tres:
  • Informacion Undo Uncommited o Active (Sin Cometer)
    Da soporte a una transaccion en ejecución, y es requerida si un usuario quiere efectuar un rollback o si la transaccion falla. Este tipo de información nunca es sobreescrita
  • Informacion Undo Commited o Unexpired (Cometida)
    Esta información ya no es requerida por la transacción, pero es necesaria para cumplir con el intervalo de tiempo definida en el UNDO_RETENTION (veremo mas abajo la definicion de este).
  • Informacion Undo Expired (Expirada)
    Esta información ya no es requerida por una transacción y puede ser sobreescrita por la siguiente transacción activa.
Como mencionaba arriba, los registros de undo, tambien nos sirven para mantener la consistencia de lectura de datos,que pasa cuando un query quiere obtener información del registro tipo undo, y esta información ya ha sido sobrescrita, si eso te llega a suceder, vas a ver el siguiente error ORA-01555 Snapshot Too Old . Este error lo que  te esta diciendo es que el query necesita una "fotografia" de los datos a como estaba en un punto pasado y reconstruir esta "fotografia" de datos requiere información del registro tipo undo que ya no se encuentra en él.

Oracle usa una retencion de undo (Undo Retention) manejada en segundos, cuando el tablespace de tipo undo se maneja con la opcion AUTOEXTEND, Oracle retiene la informacion de tipo undo por el tiempo minimo que el parametro UNDO_RETENTION tiene, nada mas que hay un detalle a saber, que si el tablespace ya no tiene suficiente espacio para crecer, va a empezar a utilizar espacio que ocupa la información sin expirar (UNEXPIRED), que esto puede causar un error de tipo ORA-01555.

Ahora que ya sabemos que son, que puedo hacer con esta información?
Vamos a ver un pequeño ejemplo con el usuario hr y vas a poder ver una transacción y el espacio que esta consumiendo de undo.

Primera que nada vamos a verificar el SID tenemos asignado y crear una tabla llamada prueba

TESTDB >select sys_context('USERENV','SID') from dual;
SYS_CONTEXT('USERENV','SID')
----------------------------------------------------------------
69

TESTDB >create table prueba (idprueba number);
Table created.


Con el siguiente query,verificamos que ninguna transacción esta activa en nuestra sesion, el resultado debe de ser un valor nulo.


TESTDB >select dbms_transaction.local_transaction_id from dual;
LOCAL_TRANSACTION_ID
--------------------------------------

Luego creamos un pequeño bloque de pl/sql que inserte datos en la tabla que creamos, y es muy importante que no le des commit


TESTDB >begin
  2  for i in 1..10000 loop
  3  insert into prueba values (i);
  4  end loop;
  5  end;
  6  /
PL/SQL procedure successfully completed.


Volvemos a verificar la transacción, y te vas a dar cuenta que como hicimos un insert y no hemos hecho commit, nos regresa un resultado, significando que a nuestra transacion se le asigno un identificador o XID

TESTDB >select dbms_transaction.local_transaction_id from dual;
LOCAL_TRANSACTION_ID
--------------------------------------
47.29.15324


Estos tres numeros son en el orden en que aparecen:
  • El identificador del segmento undo donde la transaccion registra su informacion undo.
  • El numero de Slot undo en el segmento undo
  • El numero secuencial en el Slot de undo

Pero esta información que te muestro arriba, dado que es util saber, normalmente tenemos que ver transacciones que no nos pertenecen, por eso existe una vista llamada v$transaction, en donde podemos verificar transacciones que esta sucediendo en otra parte. Y aqui vas a encontrar tres campos que se te van a hacer muy familiares

  • XIDUSN.-El identificador del segmento undo donde la transaccion registra su informacion undo.
  • XIDSLOT.-El numero de Slot undo en el segmento undo
  • XIDSQN.-El numero secuencial en el Slot de undo

Con el query que se encuentra abajo, puedes ver la relacion con la sesion y la cantidad de undo en megas que esta utilizando la sesion:


select r.name,s.sid,s.serial#,s.module,
    to_char(s.logon_time, 'mm/dd/yy hh24:mi:ss') as login_time,
    xidusn, xidslot, xidsqn,
    t.used_ublk * to_number(x.value)/(1024*1024) as undo_mb
from v$session s,v$transaction t,v$rollname r,v$parameter x
where s.saddr = t.ses_addr and r.usn = t.xidusn
    and x.name = 'db_block_size';


Rollback Segment      SID,Serial   Module               Login Time            XIDUSN    XIDSLOT     XIDSQN      Undo MB
--------------------- ------------ -------------------- ----------------- ---------- ---------- ---------- ------------
_SYSSMU47_1546937756$ 69,1043      SQL*Plus             01/18/11 18:35:40         47         29      15324        .9141

Conclusion
Conocimos lo que era una transacción, asi como lo que es la definición de undo, de la misma manera que una vez que una transacción inicia, se guarda en un registro tipo undo, la informacion antes de ser cometida (UNCOMMITED) para poder hacer un rollback y tambien para tener consistencia en la lectura de datos una vez que esta fue cometida (COMMITED).